La Decisions API d’OpenAI est passée en bêta publique le 6 octobre 2026 : GPT-6 Luna renvoie des jugements typés plutôt qu’une longue réponse conversationnelle. Elle intéresse les applications qui doivent classer des demandes, choisir une catégorie ou prioriser de nombreux éléments sans transformer chaque opération en discussion.
C’est une évolution concrète après l’annonce du DevDay : un endpoint dédié et une documentation opérationnelle sont disponibles. Cela ne signifie pas que le modèle doit prendre seul toutes les décisions d’une entreprise. Son résultat reste une évaluation dans un système doté de règles et de contrôles.
Decisions API : quels résultats renvoie-t-elle ?
Le journal officiel des changements confirme l’ouverture de la bêta. La documentation distingue trois formes de question pour des tâches dont le résultat attendu est limité.
| Type | Question adaptée | Résultat |
|---|---|---|
| Predicate | Une condition est-elle présente ? | Probabilité estimée |
| Choice | Quelle catégorie prédéfinie convient ? | Choix parmi les options fournies |
| Score | Quel niveau ordonné décrit le cas ? | Score calculé à partir de la distribution |
| État du service | La version générale est-elle définitive ? | Bêta publique, pas une GA déjà achevée |
Choisir un département n’est pas rédiger un texte libre. Une note d’urgence n’est pas une autorisation. Le format réduit facilite l’intégration, mais ne prouve pas que l’interprétation de la demande soit correcte.
Exemple : orienter les messages d’assistance
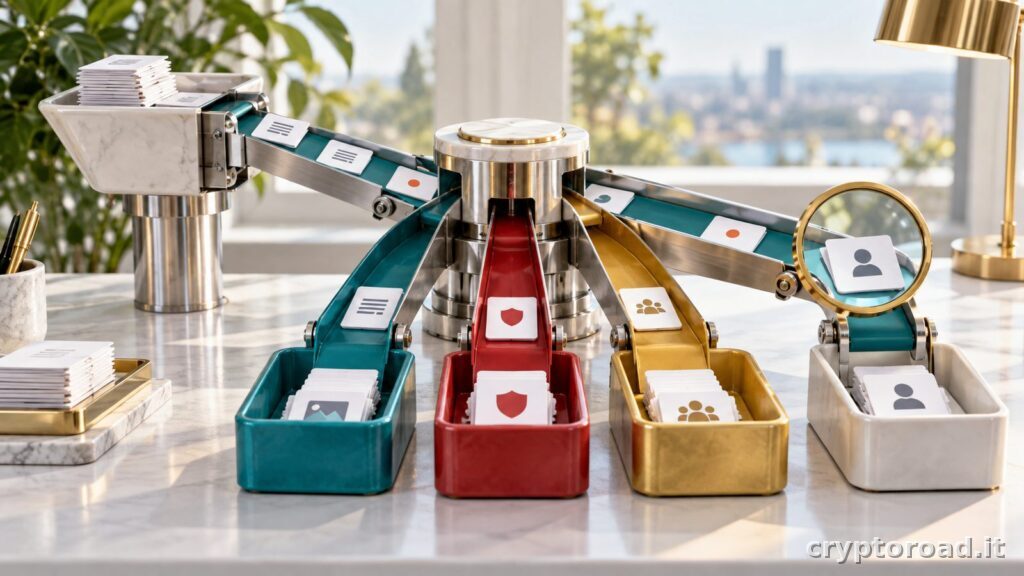
Imaginons trois destinations : facturation, support technique et révision humaine. L’application reçoit un message et cherche le parcours le plus plausible. La tâche est différente de la rédaction d’une réponse complète au client : il s’agit d’un petit jugement intermédiaire.
Les catégories doivent avoir des sens distincts. Si « problème de compte » et « problème technique » se recouvrent sans critères, l’ambiguïté appartient déjà au processus. Un parcours de révision évite de forcer tous les messages incertains dans un mauvais service.
Le guide officiel documente cette utilisation avec GPT-6 Luna. Les exemples possibles ne constituent pas une mesure de précision pour votre entreprise. Des cas étiquetés et des résultats attendus sont nécessaires avant l’adoption.
Prix : ne pas confondre Decisions et Responses
Le tarif de base documenté est de 0,10 dollar par million de tokens d’entrée, sans frais de tokens de sortie ni d’opérations de cache. Les majorations régionales et multiplicateurs de contexte long applicables restent à prendre en compte.
Exemple arithmétique : 10 000 demandes de 1 000 tokens d’entrée représentent dix millions de tokens, soit 1 dollar au tarif de base. Ce n’est pas une estimation de production. Images, contexte supplémentaire, nouvelles tentatives et conditions de traitement peuvent changer le total.
Le même modèle utilisé par d’autres endpoints suit le tarif correspondant. La présence de gpt-6-luna dans deux produits ne permet pas de transférer automatiquement hypothèses de coût et comportement de l’un à l’autre.
Interpréter correctement la promesse de vitesse
OpenAI présente ces jugements comme plus rapides que l’utilisation conversationnelle via Responses. C’est une comparaison du fournisseur, pas un gain garanti pour tout réseau, contenu ou application. La promesse « jusqu’à dix fois plus rapide » doit être testée sur la tâche concernée.
Mesurez le parcours complet : préparation de la preuve, appel, validation et gestion des échecs. Une requête rapide ne corrige pas un processus flou si de nombreux résultats exigent une reprise humaine. Un contexte insuffisant peut également rendre la réponse inutilisable.
Comparez la même question sur un échantillon fixe. Opposer une classification courte à un rapport long ne démontre pas une supériorité générale. La nature du résultat demandé fait partie de la comparaison de performance.
Entrées acceptées et refus possibles
La référence de l’endpoint décrit texte et images inline. Ce n’est pas un agent qui navigue seul, ouvre n’importe quel fichier ou utilise des outils. Les éléments à évaluer doivent être fournis dans le format accepté.
Une question peut aussi recevoir un refus. Le programme doit distinguer jugement valide et demande non évaluée. L’absence de réponse ne démontre pas qu’une condition est fausse. Les timeouts et erreurs du service nécessitent eux aussi un parcours explicite.
Un repli prudent transmet le cas à une personne. Il ne transforme pas silencieusement une panne technique en approbation. Ce point compte particulièrement lorsque le classement influence comptes, paiements ou contenus publics, avec des conséquences dépassant une simple mauvaise étiquette.
Une probabilité n’est pas une preuve
Un chiffre élevé reste une estimation du modèle. Les seuils doivent dépendre du coût des erreurs. Mal orienter une question générale et manquer une demande urgente n’ont pas les mêmes conséquences ; une règle identique n’est donc pas forcément adaptée.
La distinction entre jugement sémantique et règle certaine est également au cœur de notre présentation de Jev de TypeSafe AI. Des problèmes similaires ne signifient pas des API, prix ou qualités équivalents. Chaque produit exige une évaluation distincte.
Calculs, parsing fiable et autorisations relèvent du code déterministe. Le modèle devient utile pour interpréter un sens ambigu, pas lorsqu’une règle exacte résout déjà mieux la tâche et reste plus facile à contrôler.
Quand faut-il choisir une autre API ?
Pour un objet complexe, une explication développée ou des appels d’outils, choisissez le produit correspondant. Decisions ne remplace pas universellement la génération structurée ni les workflows d’agents. Sa valeur tient aussi au fait qu’elle vise un résultat étroit.
Notre compte rendu du DevDay donne le contexte de la plateforme. La bêta de Decisions API ajoute un composant spécialisé : un jugement identifiable et testable dans un processus plus large.
Avant l’intégration, testez des cas ordinaires, ambigus et adverses, définissez les replis et vérifiez si les choix améliorent réellement le travail. La nouveauté n’est pas de tout confier à l’IA, mais de lui poser une question plus précise tout en contrôlant les conséquences.