La Decisions API di OpenAI è entrata in beta pubblica il 6 ottobre 2026: usa GPT-6 Luna per restituire giudizi tipizzati invece di una lunga risposta conversazionale. Il prodotto interessa chi deve classificare richieste, scegliere fra categorie o assegnare priorità a molti elementi senza trasformare ogni operazione in una chat.
È un passaggio concreto rispetto all’annuncio del DevDay: ora c’è un endpoint dedicato e una documentazione operativa. Non significa che il modello possa prendere autonomamente qualsiasi decisione aziendale. Il risultato resta una valutazione da inserire in un sistema con regole, soglie e controlli.
Decisions API: cosa restituisce davvero
Il changelog ufficiale registra l’apertura della beta. La guida distingue tre tipi di domanda, utili quando il risultato desiderato è piccolo e il problema è circoscritto.
| Tipo | Domanda adatta | Risultato |
|---|---|---|
| Predicate | Una condizione è presente? | Probabilità stimata |
| Choice | Quale categoria predefinita è più adatta? | Scelta fra opzioni |
| Score | Quale livello di una scala descrive il caso? | Punteggio basato sulla distribuzione dei livelli |
| Stato del servizio | È una versione definitiva? | Beta pubblica, non disponibilità generale già conclusa |
Una scelta fra reparti non è un testo libero. Un punteggio di urgenza non è un’autorizzazione. Un formato ristretto semplifica l’integrazione, ma non dimostra che l’interpretazione dell’input sia giusta.
Un esempio: instradare messaggi di assistenza
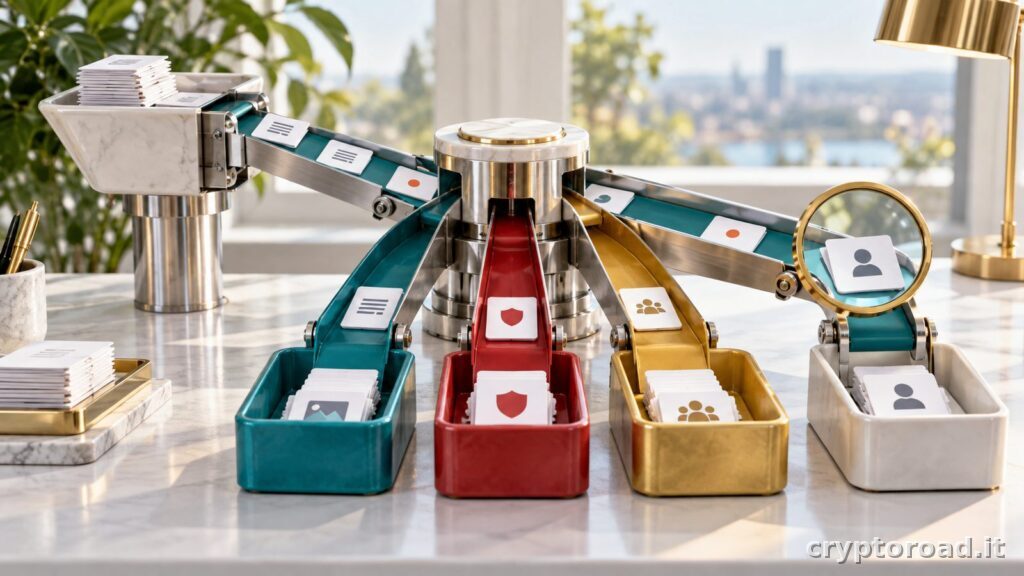
Immagina tre destinazioni: fatturazione, problema tecnico e revisione umana. Il sistema riceve un messaggio e deve scegliere il percorso più plausibile. È diverso dal chiedere di scrivere una risposta completa al cliente: il compito è una piccola decisione intermedia.
Le categorie devono avere significati distinti. Se “problema account” e “problema tecnico” si sovrappongono senza criteri, l’ambiguità è nel processo prima ancora che nel modello. Un’opzione per i casi non risolvibili evita di forzare ogni messaggio dentro un reparto sbagliato.
La guida ufficiale alla Decisions API documenta l’uso con GPT-6 Luna. Gli esempi possibili non vanno scambiati per accuratezza misurata sul tuo servizio: prima servono dati etichettati e risultati attesi.
Quanto costa e perché il prezzo è diverso da Responses
Il listino documentato per questo endpoint è di 0,10 dollari per milione di token di input, senza addebiti per token di output o operazioni di cache. Restano applicabili maggiorazioni regionali e moltiplicatori previsti per contesti lunghi: non è un prezzo universale senza condizioni.
Un esempio aritmetico: 10.000 richieste da 1.000 token di input ciascuna totalizzano 10 milioni di token e 1 dollaro alla tariffa base. Non è una stima di produzione: immagini, contesto aggiunto, tentativi ripetuti e condizioni applicabili possono cambiare il totale.
Le richieste allo stesso modello attraverso altri endpoint seguono il listino pertinente. La presenza di gpt-6-luna in due servizi non permette di trasferire automaticamente costi e comportamento dall’uno all’altro.
“Fino a dieci volte più veloce” richiede un confronto corretto
OpenAI presenta il prodotto come più rapido per questi giudizi rispetto all’uso conversazionale tramite Responses. È una dichiarazione del fornitore, non una velocità garantita per ogni rete, input e applicazione.
Misura il tempo dell’intero percorso: preparazione dei dati, chiamata, validazione e gestione di un eventuale errore. Un servizio veloce non migliora il processo se una domanda poco chiara provoca molte revisioni o se il risultato arriva senza il contesto necessario.
Per una valutazione sensata, confronta la stessa domanda su un campione fisso. Non mettere a confronto una classificazione breve con un rapporto lungo e concludere che un sistema sia sempre superiore.
Input supportati e casi di rifiuto
La referenza dell’endpoint descrive testo e immagini inline. Non va trattato come un agente che naviga autonomamente, apre file a piacere o esegue strumenti.
La documentazione prevede anche risultati di rifiuto. Il codice deve distinguere una risposta valida da una domanda non valutata: l’assenza di un giudizio non significa che la condizione sia falsa. Timeout e problemi di servizio richiedono un percorso esplicito.
Un fallback prudente può inviare il caso a revisione umana. Non deve trasformare silenziosamente un errore tecnico in un’approvazione. Questo è particolarmente importante quando la classificazione influenza pagamenti, account o contenuti pubblici.
Probabilità non significa certezza
Un valore alto esprime una stima del modello, non una prova. Le soglie devono dipendere dal costo degli errori: instradare male una domanda generica non ha le stesse conseguenze di ignorare una richiesta urgente.
La distinzione fra giudizio semantico e regola certa è già centrale nel nostro approfondimento su Jev di TypeSafe AI. La somiglianza del tipo di problema non implica che i prodotti abbiano API, prezzi o qualità equivalenti.
Per calcoli, parsing affidabile e autorizzazioni, usa codice deterministico. Il modello ha senso dove occorre interpretare un significato ambiguo; non dove una regola precisa risolve già il compito meglio e in modo controllabile.
Quando usare un’altra API
Se serve generare un oggetto complesso, una spiegazione articolata o una chiamata a strumenti, il prodotto va scelto per quel risultato. Decisions non è una scorciatoia per sostituire tutte le risposte strutturate o tutti i flussi agentici.
Il nostro resoconto del DevDay offre il contesto della piattaforma. Questa beta aggiunge un componente più specifico: un giudizio piccolo, identificabile e verificabile dentro un processo più grande.
Prima dell’adozione, prova casi ordinari, ambigui e avversi; definisci fallback e verifica se le scelte migliorano davvero il lavoro. La novità non è affidare tutto all’AI, ma poterle assegnare una domanda più stretta e mantenere il controllo sulle conseguenze.